数字人 / 生成式 AI
面向数字人呈现的生成式媒体核心:双引擎 TTS 语音合成、音色管理、字级语音-文本强制对齐与字幕 / 口型驱动的视频合成。
- 双引擎 TTS 语音合成,支持多音色管理与语速控制
- ASR 字词声音时间戳与讲稿逐字匹配的字级强制对齐
- 面向字幕 / 口型驱动的模块化生成式媒体流水线
Part of AI 教学视频生成平台 本模块负责数字人语音与媒体呈现(Digital Presentation)。
一个面向数字人风格视频的生成式媒体流水线:TTS 语音合成、受控音色、字级语音-文本强制对齐与视频合成——这是驱动数字人内容的语音与对齐核心。
项目概述
数字人视频需要三个紧密耦合的部分:可信的合成语音、音频与文本之间的精确对齐(用于字幕与口型同步)、以及视频合成。本项目构建这一生成式媒体核心,并保证生产级可靠性。
本项目聚焦数字人的呈现驱动核心——可信语音、精确对齐与视频合成;课程内容如何自动生产,参见 AI 课程自动生产系统。两个项目共享底层 TTS 与对齐能力,边界清晰:一个解决「课程内容生产」,一个解决「AI 教师呈现」。
问题
- 单一 TTS 引擎无法满足内容对音色、语速与质量的多样化要求。
- 字幕与数字人口型动画都依赖音频与讲稿之间精确的字 / 词级对齐。
- 媒体生成必须在 GPU 基础设施上作为可靠、可续跑的流水线长期运行。
解决方案
构建模块化的生成式媒体流水线:
- TTS 语音合成:双引擎(CosyVoice 3 + IndexTTS 2.5),支持多音色管理、语速控制、多 GPU 并行、失败重试与断点续跑。
- 字级语音-文本强制对齐:VAD 切分后由 FunASR Paraformer 识别出带发音时间的字词,再与讲稿逐字匹配,将声音时间戳映射回讲稿。
- 视频合成:将对齐后的音频接入字幕与数字人渲染,合成并导出最终 MP4。
系统架构
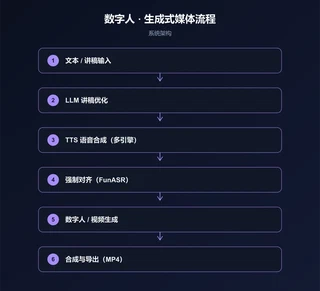
讲稿文本 → TTS 语音合成 → 字级强制对齐 → 字幕 / 口型驱动 → 视频合成导出
核心技术挑战
可靠的多引擎语音合成
不同内容对音色与风格的要求不同,单引擎方案天花板明显:
- 引擎无关的 TTS 统一封装,提供音色、语速等一致的参数接口。
- 多 GPU 并行与断点续跑,使长媒体任务在失败后无需整体重跑。
字级语音-文本强制对齐
正确的字幕与自然的口型同步都以精确时间戳为前提:
- 以 ASR 识别字词的发音时间为锚,与讲稿逐字匹配,把时间戳精确落到讲稿的每个字 / 词上。
- 对齐结果同时供字幕轨与口型驱动消费,保证两条链路时间一致。
生产集成
各阶段为模块化流水线任务,带断点管理与中间结果缓存,可在 GPU 推理环境稳定部署。
工程实现
- 统一 TTS 层封装双引擎,支持音色与语速控制。
- 强制对齐模块产出带时间戳文本,供字幕与数字人阶段使用。
- 基于 FFmpeg 的视频合成与导出。
- 容器化部署于 GPU 推理环境。
项目成果
输入:讲稿文本 + 音色配置
输出:配音 + 字 / 词级时间戳 + 数字人风格视频(MP4)
双引擎 TTS 统一封装,多音色 / 语速可控
字级语音-文本强制对齐时间戳输出
字幕与口型驱动链路打通
多 GPU、可断点续跑的批量执行
视频合成与 MP4 导出
演示
流水线生成带对齐字幕的配音,驱动数字人风格视频,并合成导出最终 MP4。
技术栈
语音:CosyVoice 3 · IndexTTS 2.5 · 多音色管理 对齐:FunASR (Paraformer) · VAD · 字 / 词级时间戳 视频:FFmpeg · 视频合成 工程:Docker · GPU 推理 · 断点流水线
我的贡献
设计并构建生成式媒体流水线:
- 双引擎 TTS 统一封装与多音色管理
- 字级语音-文本强制对齐模块
- 带断点的模块化任务流水线
- 字幕 / 口型驱动的视频合成导出流程
该项目完整体现了我从 生成式语音模型集成、字级语音-文本强制对齐到多模态视频合成落地 的多模态 AI 工程能力。
应用前景与可扩展方向
当前「语音 → 对齐 → 合成」核心链路已可运行,其模块化设计具备向更完整数字人产品延展的空间:
应用场景
- 数字人讲师课程:与 AI 课程自动生产系统 组合,形成从课程内容生产到教师呈现的完整闭环。
- 多语种口型:复用对齐能力扩展多语言音色,一套流程生成多语种数字人视频。
- 品牌虚拟形象:为企业定制固定音色与形象的批量短视频生产。
可扩展技术方向
- 实时交互数字人:从离线合成走向低延迟对话式呈现。
- 情感与韵律控制:在现有参数之上引入细粒度情感调节。
- 半身 / 全身驱动:由语音时间戳进一步驱动肢体动作序列。