AI 教学视频生成平台
从课程内容生成到数字人呈现的端到端 AI 教学视频生产系统:Content Generation 与 Digital Presentation 解耦,通过统一的文本、音频与时间轴接口连接 LLM、TTS、语音对齐与视频合成。
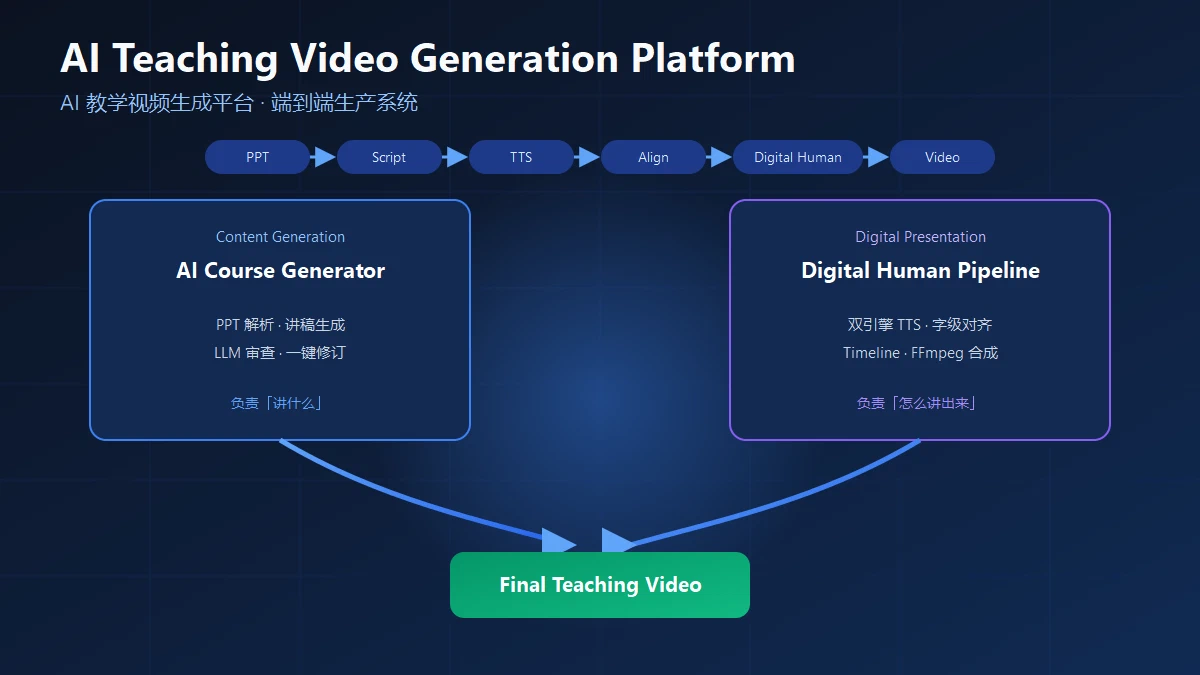
- 双模块架构:Content Generation(AI Course Generator)+ Digital Presentation(Digital Human Media Pipeline)
- 多引擎 TTS 统一封装:CosyVoice 3 + IndexTTS 2.5,上层 Pipeline 与具体引擎解耦
- 字级语音-文本强制对齐:ASR 字词声音时间戳 × 讲稿逐字匹配
- 可恢复生产管线:Checkpoint / Retry / Resume,长任务失败无需整体重跑
AI Teaching Video Generation Platform —— 从课程内容生成到数字人呈现的端到端 AI 教学视频生产系统。
核心链路:
PPT → Script → Voice → Alignment → Digital Human-ready → Video
核心技术标签:LLM · TTS · Speech Alignment · Digital Human · Multimodal · GPU Pipeline
项目概述
传统课程视频生产需要人工完成一系列环节:阅读 PPT、撰写讲稿、录制配音、制作字幕、剪辑视频、数字人呈现。每个环节都是独立的手工任务,成本高、难以规模化。
本系统将这些环节拆解为可组合的 AI Pipeline,由两个核心模块构成:
设计原则:Content / Presentation Separation
课程内容生产与数字人呈现解耦,两个模块只通过标准化的文本、音频和时间轴数据连接:
                AI Teaching Video Generation Platform
                                │
                ┌───────────────┴───────────────┐
                │                               │
        Content Generation            Digital Presentation
       AI Course Generator          Digital Human Media Pipeline
       PPT → Structure → Script     Script → TTS → Alignment
       Review → Revision            → Subtitle → Media → Video
                │                               │
                └───────────────┬───────────────┘
                                ↓
                        Final Teaching Video
这种解耦使内容侧可以独立改进讲稿质量,呈现侧可以独立替换 TTS 引擎或升级呈现形式,互不影响。
端到端 Pipeline
PPT / Course Material
        ↓
PPT Parsing(python-pptx)
        ↓
Course Structure(slides.json)
        ↓
LLM Lecture Script Generation
        ↓
Lecture Review / Revision(LLM-as-Judge)
        ↓
TTS(CosyVoice 3 / IndexTTS 2.5)
        ↓
Audio
        ↓
VAD + ASR(FunASR Paraformer)
        ↓
Character / Word Alignment
        ↓
Subtitle / Timeline
        ↓
Digital Human-ready Media
        ↓
FFmpeg Composition
        ↓
Final MP4
Module 01 · AI Course Generator
AI-powered course content generation
负责「讲什么」。
完整案例:AI Course Generator
核心流程:
PPT → 内容解析 → 课程结构 → LLM 讲稿生成
    → Review → Revision → Final Script
已实现:内容解析与结构化
- 基于 python-pptx 的 PPT 解析与图片渲染
- 结构化中间表示 slides.json
- 页面 / 段落 / 句子三级层级结构
- 中文 / 英文讲稿支持
已实现:LLM 讲稿生成
- 基于课程结构的结构化讲稿生成
- 页面间逻辑衔接与内容扩展
已实现:讲稿审查与修订(LLM-as-Judge)
- 重复内容检测
- 页面衔接检查
- 术语一致性检查
- 机械表达检测
- 一键修订与 human-in-the-loop 人工编辑
本模块不涉及任何数字人技术,技术边界清晰。
Module 02 · Digital Human Media Pipeline
Speech, alignment and media generation infrastructure
负责「怎么讲出来」。
完整案例:Digital Human Media Pipeline
需要明确的是:这个模块不是数字人建模系统,而是数字人呈现所依赖的语音与媒体基础设施。当前能力链路:
Script → TTS → Audio → Alignment → Subtitle / Timeline
      → Digital Human-ready Media → Video Composition
多引擎 TTS 统一封装
集成 CosyVoice 3 与 IndexTTS 2.5 双引擎:
        Unified TTS Interface
音色管理 · 语速控制 · 引擎选择
                  │
        ┌─────────┴─────────┐
    CosyVoice 3         IndexTTS 2.5
        └─────────┬─────────┘
             Audio 输出
已实现能力:
- 统一 TTS 抽象层(Unified TTS abstraction)
- 音色 / Speaker 配置管理
- 语速控制
- 多引擎可选
- 多 GPU 执行
- 重试(Retry)
- 检查点(Checkpoint)与缓存(Cache)
- 断点续跑(Resume)
不同 TTS 引擎具有不同的 API、模型依赖、GPU 占用和输出格式。统一 TTS 抽象使上层 Pipeline 与具体引擎解耦:新增或替换引擎时,不需要修改下游任何阶段。
字级语音-文本强制对齐
时间戳来自声音本身:TTS 音频先经 VAD 切分语音段,再用 FunASR Paraformer 识别出每一个字 / 词——识别结果天然携带真实的发音时间;随后将识别出的字词序列与原始讲稿逐字匹配,把声音时间戳映射回讲稿文本,得到字 / 词级的课程时间轴:
TTS 音频
   ↓
VAD 语音切分
   ↓
Paraformer ASR 识别
   ↓
字词 + 真实发音时间戳
   ↓
识别字词 ↔ 讲稿文本 逐字匹配
   ↓
时间戳映射回讲稿
   ↓
Timeline JSON(字 / 词级)
为什么不能按字符数估算字幕时间:长句、停顿、语速变化、中英文混读、标点和 TTS 韵律变化都会让估算产生累积误差。使用真实音频时间戳生成时间轴,字幕与语音才能逐字对齐。
Timeline 作为统一接口
对齐后的时间轴不只是字幕数据,而是整个媒体生产的统一时间轴接口:
Aligned Timeline
       │
       ├── Subtitle(字幕轨)
       │
       ├── Lip-sync Driver(Future:为后续数字人口型驱动提供统一时间轴接口)
       │
       └── Video Composition(视频合成)
字幕与视频合成都直接消费同一份 Timeline JSON;后续接入口型驱动时,同样复用这份时间轴,无需重新对齐。
生产级可恢复 Pipeline
Task
 ↓
Dispatcher
 ↓
GPU Worker
 ↓
TTS / Alignment / Rendering
 ↓
Intermediate Result
 ↓
Checkpoint
 ↓
Next Task
面向长时间媒体任务设计可恢复 Pipeline,使单个句子、页面或阶段失败时无需重新执行整个任务:
- 多 GPU 与 Worker 化执行
- Task 级状态管理与失败隔离(Failure isolation)
- Retry 自动重试
- Checkpoint 检查点与中间结果缓存(Intermediate cache)
- Resume 断点续跑
视频合成
Audio + Subtitle + Background / PPT + Digital Human-ready Video
                          ↓
                       FFmpeg
                          ↓
                      Final MP4
FFmpeg 在系统中不只是「导出工具」,而是整个媒体时间轴最终落地的 composition layer:音频轨、字幕轨、背景 / PPT 画面与数字人就绪画面按统一时间轴合成为最终教学视频。
演示
平台当前以本地服务方式运行:通过 Gradio Web UI 上传课程 PPT 或讲稿文本,即可走完上述端到端流程,产出带讲解配音与字级同步字幕的课程视频(MP4)。
两条典型路径:
- 端到端:上传 PPT → 自动解析、生成并审查讲稿 → TTS → 对齐 → 合成成片
- 直接配音:已有讲稿文本 → TTS → 对齐 → 合成成片
技术架构
Input
│
├── PPT / Course Material
└── Script Text
        │
        ↓
Content Layer ── AI Course Generator
│               (Parsing · Script · Review)
        ↓
Speech Layer
│
├── CosyVoice 3
└── IndexTTS 2.5
        │
        ↓
Alignment Layer
│
├── VAD
├── FunASR Paraformer
└── Text Matching
        │
        ↓
Timeline Layer
│
├── Character timestamps
├── Word timestamps
└── Subtitle data
        │
        ↓
Presentation Layer ── Digital Human / Lip-sync(Future)
        │
        ↓
Media Layer ── FFmpeg Composition
        │
        ↓
Final MP4
Scope
当前项目聚焦 AI 教学视频生产中的内容生成、语音合成、语音-文本时间轴和媒体合成基础设施。
数字人角色建模、完整 Avatar 系统、实时交互和复杂身体动作生成不属于当前核心范围,相关方向见下方 Future。
我的贡献
负责整体架构设计与核心 Pipeline 实现,从 LLM 课程内容生成、TTS、语音-文本时间轴对齐到最终视频合成,完成跨模型、跨阶段的媒体生产链路集成:
- Designed the end-to-end architecture(端到端架构设计)
- Designed the separation between content generation and presentation(内容与呈现解耦)
- Built unified multi-engine TTS layer(多引擎 TTS 统一封装)
- Implemented character / word-level alignment pipeline(字 / 词级对齐流水线)
- Designed reusable timeline interface(可复用时间轴接口)
- Built checkpoint / retry / resume mechanism(可恢复生产管线)
- Integrated GPU inference workloads(GPU 推理工作负载集成)
- Built final media composition pipeline(FFmpeg 媒体合成层)
- Integrated multiple AI models into a production-oriented workflow(多模型工程化集成)
Future
Digital Human Lip-sync
将统一时间轴接入数字人口型驱动模型,实现语音驱动的口型同步。
Real-time Digital Human
从离线 Pipeline 向低延迟实时交互演进。
Prosody / Emotion Control
进一步控制 TTS 的情绪、韵律、停顿和表达风格。